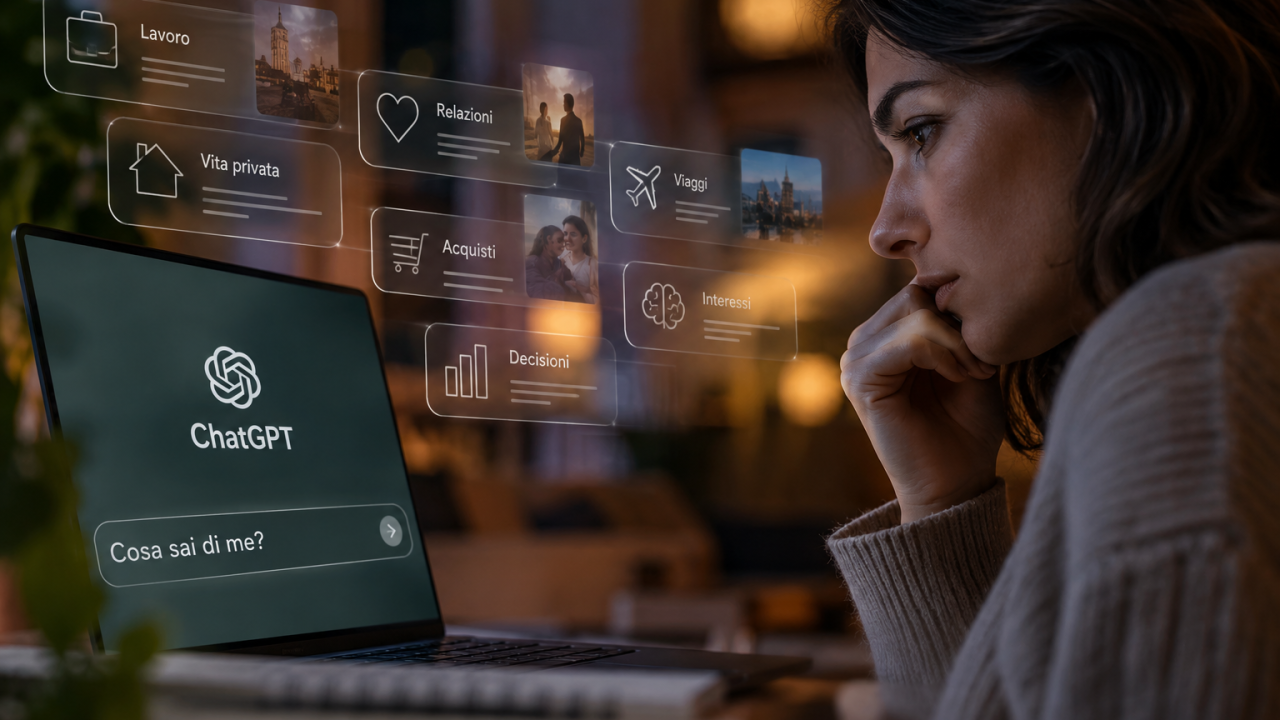
Apriamo ChatGPT, facciamo una domanda e chiudiamo. Poi torniamo. E raccontiamo qualcos’altro.
Un problema di lavoro. Un viaggio. Un acquisto. Una preoccupazione. Una decisione difficile. Una relazione personale.
Presi singolarmente sembrano frammenti senza importanza. Ma proviamo a cambiare prospettiva.
Che ritratto potrebbe costruire un’intelligenza artificiale mettendo insieme ciò che le abbiamo raccontato nel tempo?
È la provocazione di un contenuto diventato virale sui social: interrogare ChatGPT non su un argomento esterno, ma su noi stessi. Il post arriva a suggerire di chiedere all’IA di individuare aspetti della nostra personalità che non vediamo e persino di anticipare come potremmo comportarci davanti a denaro, stress, conflitti o rischi.
Fantascienza? Non esattamente.
Occorre capire che cosa sta realmente accadendo.
Esiste davvero un dossier digitale su ciascuno di noi? Non propriamente.
La memoria di ChatGPT non deve essere immaginata come un fascicolo segreto nel quale sia trascritta ogni parola pronunciata dall’utente.
OpenAI spiega che la funzione Memoria consente di utilizzare informazioni provenienti dalle interazioni precedenti per personalizzare le risposte, ma ciò non significa che venga necessariamente conservato ogni dettaglio di ogni conversazione.
La domanda, allora, diventa un’altra: serve davvero possedere un dossier completo per arrivare a delineare una persona?
Probabilmente no.
È sufficiente collegare informazioni diverse. Ed è qui che il tema diventa giuridicamente interessante.
Quanto può capire l’IA senza che glielo abbiamo dichiarato?
Immaginiamo di non aver mai scritto: “Ho una vita professionale molto stressante”.
Tuttavia di aver raccontato per mesi scadenze, riunioni, trasferte, telefonate, responsabilità e problemi.
Se il sistema conclude che svolgiamo un’attività particolarmente intensa, quell’informazione non gli è stata comunicata direttamente.
L’ha ricavata da altre informazioni.
Ed è proprio il tema delle inferenze a rendere la profilazione digitale molto più complessa della semplice raccolta dei dati che consapevolmente forniamo.
Il GDPR, non a caso, adotta una definizione molto ampia di dato personale e disciplina espressamente la profilazione, cioè il trattamento automatizzato utilizzato per valutare aspetti personali relativi, tra gli altri, a situazione economica, preferenze, interessi, affidabilità e comportamento.
E allora la domanda cambia ancora: non dovremmo preoccuparci soltanto di ciò che un sistema conserva, ma anche di ciò che riesce a dedurre?
Può anticipare una nostra scelta? Qui bisogna essere molto chiari.
ChatGPT non conosce il futuro.
Se gli chiediamo quale potrebbe essere la nostra prossima decisione, produce una previsione sulla base delle informazioni disponibili e delle regolarità che individua.
Ma il problema più interessante è un altro. Che effetto determina su di noi una previsione quando ci appare sorprendentemente plausibile?
C’è una grande differenza tra domandare a una macchina “Quali possibilità ho?” e chiederle “Considerando quello che sai di me, quale strada pensi che sceglierò?”
Nel secondo caso non stiamo più utilizzando soltanto uno strumento per ottenere informazioni. Gli stiamo chiedendo di restituirci un’immagine di noi stessi.
E se quell’immagine fosse convincente, ma sbagliata? Questo, a mio avviso, è il punto più delicato.
L’intelligenza artificiale conosce ciò che le mostriamo.
Potremmo averle raccontato soprattutto i problemi e quasi mai i momenti felici. Potremmo averla utilizzata prevalentemente quando eravamo sotto pressione. Potremmo averle affidato una parte molto specifica della nostra vita.
Il profilo risultante potrebbe quindi essere coerente, dettagliato e persino sorprendente.
Ma coerenza non significa verità.
E un’analisi formulata con grande sicurezza non diventa, per questo, una descrizione esatta della persona. Non è tecnicismo. È consapevolezza digitale.
La vera domanda non è più soltanto quali dati ho fornito, ma anche che cosa può emergere mettendole insieme.
Perché nome, professione, città, interessi, acquisti, viaggi, problemi e decisioni, isolatamente, raccontano piccoli pezzi di noi. Collegati tra loro possono narrare molto di più.
E probabilmente questa è una delle nuove frontiere della privacy nell’era dell’intelligenza artificiale.
Non chiedersi soltanto “Che cosa sa di me?”, quanto “Che cosa può arrivare a capire di me?”
E soprattutto, se un giorno un’intelligenza artificiale riuscisse ad anticipare con una certa precisione alcune nostre decisioni, continueremmo a considerarla soltanto uno strumento oppure inizieremmo, senza accorgercene, a lasciarci influenzare dall’immagine che ci restituisce di noi stessi?
A mio parere la vera educazione digitale inizia proprio qui. Non dalla paura dell’intelligenza artificiale. Dalla consapevolezza di quanto di noi le stiamo affidando.
Avv. Simona Maruccio
Giornalista pubblicista, opera da molti anni nel settore della compliance aziendale, del marketing e della comunicazione.